掌握 Plugin Evals 精髓:让 Claude Code 插件质量可测量、可回归、可进 CI
在 Claude Code 插件与 Skill 开发中,最常见的困境是:你写了一个技能,自己试了几次觉得“挺好用”,上线后却发现用户根本触发不了,或者触发了但结果不稳定。claude plugin eval(Plugin Evals)正是为了解决这个问题而生。它把“主观感觉”变成可重复、可对比、可进 CI 的数字,帮助你真正掌握插件是否在起作用。
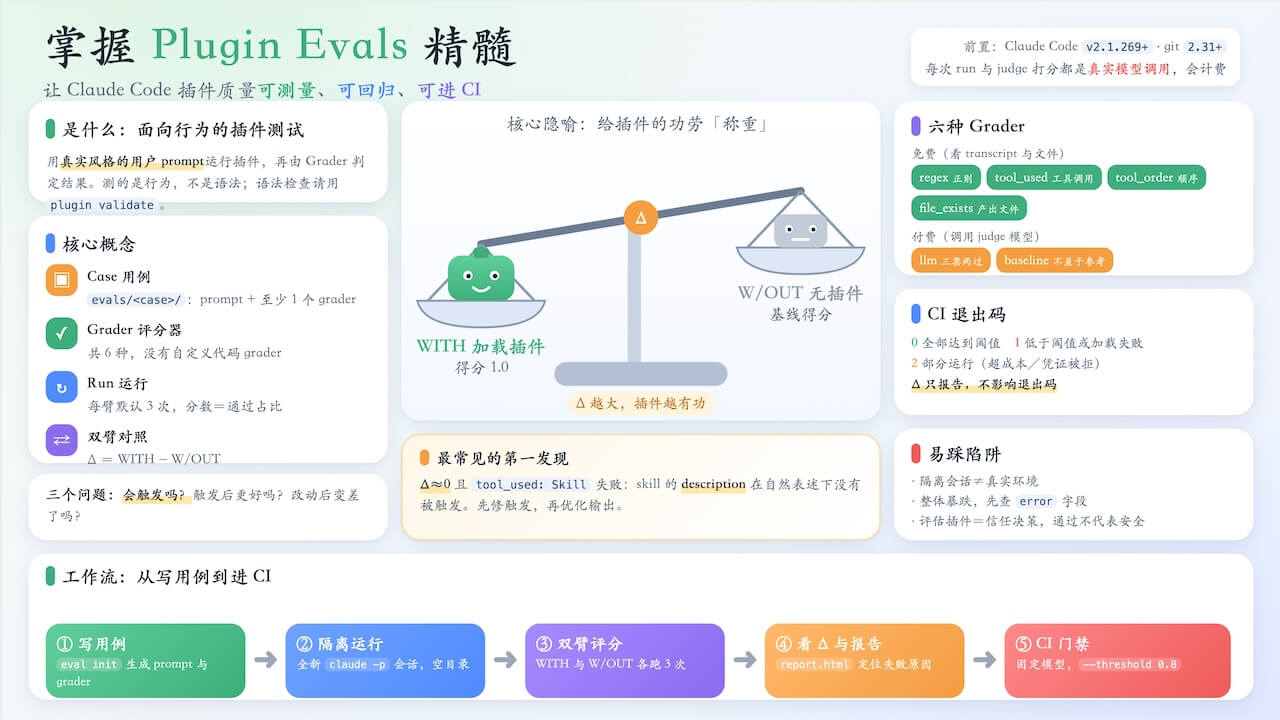
本文基于官方文档《Test plugins with evals》,从“是什么、有什么用、怎么写、怎么跑与维护、有哪些边界和陷阱”五个维度讲透它,并在最后用 15 个追问帮你检验是否真的掌握。
前置条件:Claude Code v2.1.269 及以上;git 2.31+(已安装 git 时;更旧版本会直接拒绝运行);插件根目录有
plugin.json或.claude-plugin/plugin.json;认证方式与日常使用一致。每次 run 和每次 judge 打分都是真实的模型调用,会计入订阅用量或 API 账单。
一、是什么:面向行为的插件测试
claude plugin eval 用真实风格的用户 prompt 去跑你的插件,再用 Grader 判断结果。它测的是“行为”,不是语法;语法/schema 检查请用 claude plugin validate。
1. 核心概念
- Case(用例):
evals/<case>/下的一个目录,含prompt.md(或case.yaml)+ 至少一个 grader。没有 grader 的 case 会加载失败。 - Grader(评分器):对一次 run 做通过/失败判断,共 6 种,没有自定义代码 grader:
- 免费(基于 transcript 与文件):
regex、tool_used、tool_order、file_exists - 付费(调用 judge 模型):
llm、baseline
- 免费(基于 transcript 与文件):
- Run 与评分:每个 case 默认每臂跑 3 次。一次 run 的分数 = 通过的 grader 占比(可加权),case 分数 = 各 run 的均值,case 通过 = with 臂分数 ≥
--threshold(默认 1.0)。 - 双臂对照:默认再跑 3 次“不加载任何插件”的 without 臂。得到
WITH、W/OUT与Δ = WITH − W/OUT。官方原话的精神是:两臂都是 1.0,说明通过并不是插件的功劳。
2. 一次 run 发生了什么
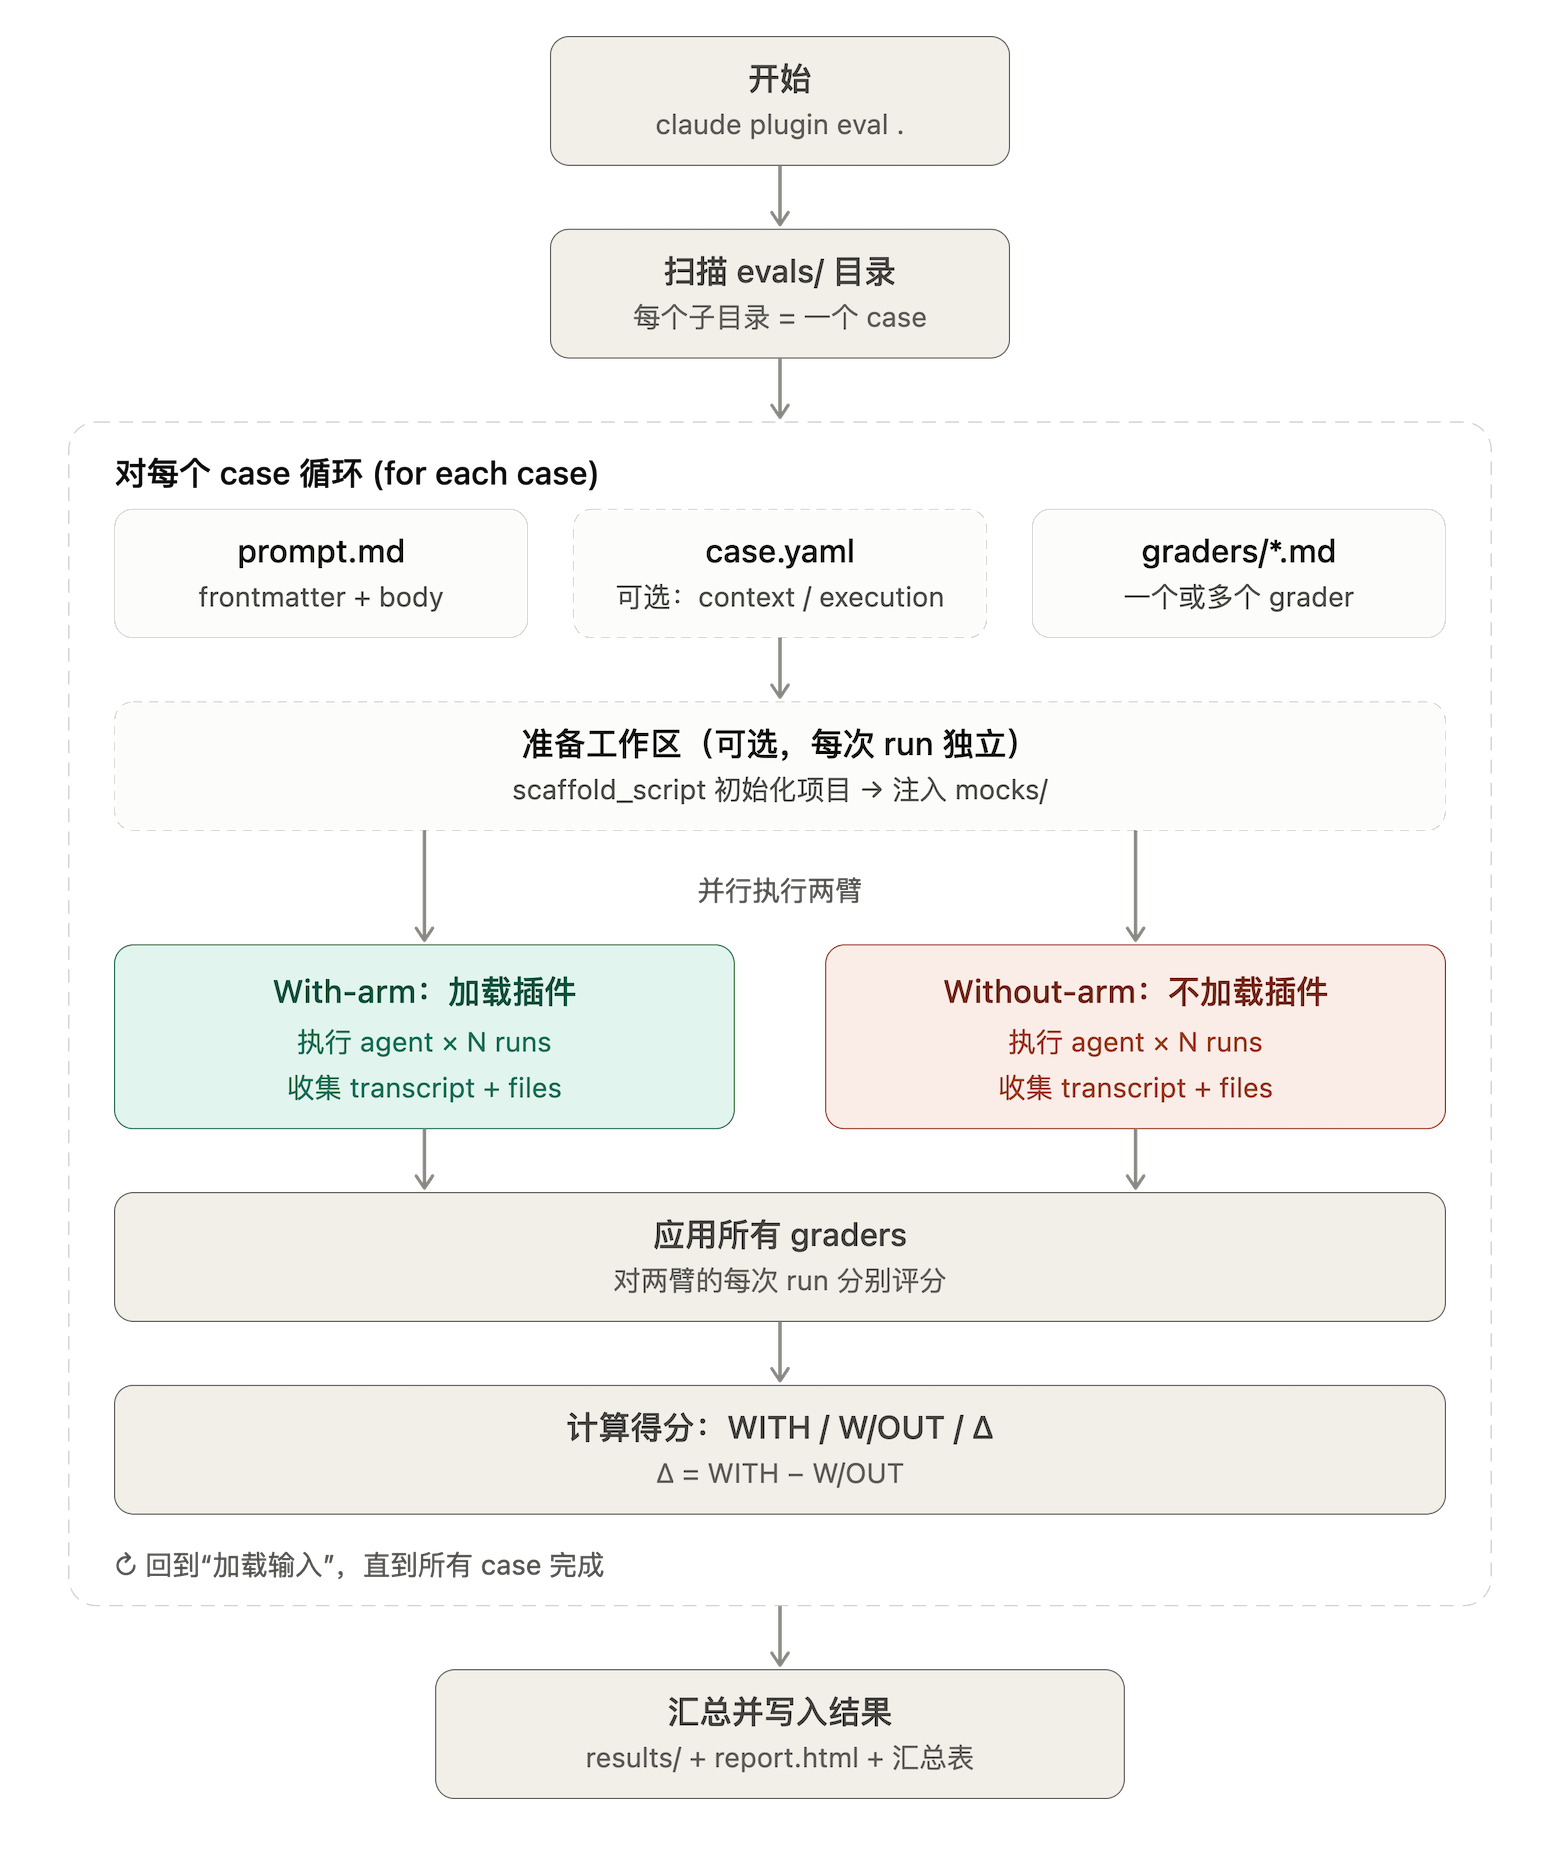
每次 run 都会启动一个全新的、隔离的非交互会话(claude -p 子进程),只加载被测插件,从空工作目录开始,直到任务完成或触达 max_turns(默认 10)/ timeout_seconds(默认 300)。之后每个 grader 检查最终回复、transcript 或产出文件。
3. 目录结构
my-plugin/
├── .claude-plugin/plugin.json
├── skills/...
└── evals/
    ├── commit-message/
    │   ├── prompt.md          # frontmatter:用例字段;正文:prompt
    │   ├── graders/
    │   │   ├── skill-fired.md # 过程检查
    │   │   └── criteria.md    # 结果检查
    │   └── case.yaml          # 可选:仅在需要 context.* 时使用
    ├── mocks/                 # 可选:套件级 MCP mock
    └── results/               # 每次运行生成,加入 .gitignore
如果 evals/ 被占用,可在 plugin.json 里写 "experimental": {"evals": "quality/evals"},或用 --eval-dir 指定。
注意:它与 skill-creator 插件使用的
evals/evals.json是两套互不识别的格式。skill-creator 适合在一次对话里迭代单个 skill,claude plugin eval适合整插件、可回归、可进 CI。
二、有什么用:回答三个问题
- 插件会被触发吗? 最常见的失败不是“结果差”,而是 Claude 在自然表述下根本没选你的 skill。
- 触发后真的更好吗? 看 Δ,而不是单看 WITH。
- 改动或换模型后有没有变差? 同一套 suite 反复跑,捕捉回归。
官方文档特别指出:最常见的第一发现是 Δ 接近 0,且 tool_used: Skill 失败——说明 skill 的 description 在这句 prompt 的表述下没有触发。
三、怎么写:从 init 到高质量用例
1. 快速开始
claude plugin eval init     # 交互式:Claude 读插件、问你“好结果”长什么样、
                            # 提议应触发/不应触发的 prompt 与 grader、试跑后写文件
claude plugin eval .        # 跑整个 suite
手写则用 claude plugin eval init --bare first-case 生成空模板(不运行任何东西,CI 里也只能用 --bare)。
2. prompt.md
---
max_turns: 10
allowed_tools: [Read, Glob, Grep, Skill]
---

帮我给这次改动写一条 commit message:我把 getUser 重命名为 fetchUser,并更新了三处调用。
要点:
- prompt 要像用户随口说的话,不要点名 skill,否则你测的是“被点名”而不是“被选中”。
- 每次 run 从空目录开始,任务需要的内容要写进 prompt 本身;
@path不会被展开为附件。 - frontmatter 不是必须,但建议至少设
allowed_tools、max_turns;未知键会报错。max_turns触顶会记为 run error 并通常拉低分数,宁可设宽松些。 - 其它字段:
name、tags、runs(1–50)、model、timeout_seconds、append_system_prompt、env(键必须是EVAL_*)。
3. Grader 组合:一个看结果,一个看过程
过程(graders/skill-fired.md):
---
type: tool_used
tool: Skill
input_match: '"skill"\s*:\s*"(?:[\w-]+:)?commit-message"'
---
结果(graders/criteria.md):
---
type: llm
---

PASS if 回复是单行 Conventional Commit 格式。
FAIL if 是散文、列表或多行内容。
各类型的通过条件:
| 类型 | 通过条件 |
|---|---|
regex |
JS 正则在 target 中命中;match: not_contains 要求不出现,match: "count:N" 要求恰好 N 次;大小写用 flags: i,不支持内联 (?i) |
tool_used |
工具调用次数(可用 input_match 过滤)落在 min(默认 1)与 max 之间;断言“从未调用”设 min: 0, max: 0 |
tool_order |
两个工具都被调用,且第一个 before 调用早于第一个 after 调用 |
file_exists |
本次 run 中 Claude 创建的文件匹配 path(或 exists: false 表示没有) |
llm |
judge 对 rubric 三次投票中至少两次 PASS |
baseline |
judge 认为本次 run 不差于参考 transcript(.jsonl) |
regex 的 target 与 llm 的 focus 可取:last_message(默认)、trace、files(仅创建的文件路径列表,不是内容)、{ source: file, path: ... }(文件内容)、mock_calls。每个 grader 还可设 weight 与 arm。
4. 让信号稳定的四个习惯
- 长输出(生成的文件)用
regex查文件内容;llm只留给短输出,rubric 写成具体的 PASS/FAIL 条件。 - 每个 case 至少一个“结果”grader + 一个“过程”grader,才能同时知道答对没、是不是插件做对的。
tool_used: Skill通过但 Δ 为负时,先怀疑 judge:小 judge 可能因格式差异误判。用--judge-model sonnet复跑并收紧 rubric。- 想验证构建/测试通过:让 Claude 跑命令并把结果写进文件,再对文件打分,同时用
tool_used的input_match断言命令确实执行过。
5. 夹具与 Mock
case.yaml:只在需要context.*时才必须写——scaffold_script(造文件/git 仓库)、history_file(接续已有对话,prompt 作为下一轮用户输入)、add_dirs(只读夹具目录)。需要schema_version: "1.1"和name。- MCP Mock:
evals/mocks/<server>/<tool>.md,正文即工具返回值,支持{{input.字段}}替换、expect:校验入参(违反则该 run 记 0 分并标记 aborted)、error: true、type: agent(让 judge 扮演服务端)。默认不启动真实 MCP server。 - 权限:run 从不弹权限询问;
Bash、Write、Edit、WebFetch、WebSearch这类需要授权的工具,没授权就直接从会话中移除。用--allow-tools Write Edit "Bash(npm test *)"授权;授予 Bash 后命令跑在 OS 沙箱里。
四、怎么跑与维护
1. 运行目标与常用参数
claude plugin eval .                         # 整个 suite
claude plugin eval evals/x/prompt.md         # 单个 case
claude plugin eval my-plugin@marketplace     # 已安装插件
claude plugin eval . --case 'commit*' --tag smoke
| 参数 | 作用 |
|---|---|
--runs <n> |
每 case 每臂的运行次数 |
--ablation none | with-without |
是否跑无插件基线 |
--threshold <0..1> |
case 通过线(默认 1.0) |
--model / --judge-model |
被测模型 / judge 模型;CI 中建议固定 |
--max-cost-usd |
成本上限(按标价估算,开跑前检查,已启动的 run 会跑完,所以可能略超) |
-j, --concurrency |
并发 1–8,共享你账号的限流 |
--json [path] |
输出结构化结果(先写 target,再写 --json) |
--no-publish |
报告只留本地 |
--keep-temp |
保留每次 run 的沙箱目录便于排查 |
成本粗算:约 case 数 × runs 次带插件 run + 同样数量的无插件 run,外加每个 llm/baseline grader 每次 run 三次短 judge 调用。
2. 日常迭代闭环
- 改 skill 的
description或逻辑。 - 用
claude plugin eval . --case <name> --runs 1 --ablation none快速看一眼。单次 run 噪声大,不能据此下结论。 - 用默认 3 次双臂重跑,观察 Δ。
- 打开
report.html:失败的 grader 默认展开并附解释,llmgrader 还会显示 judge 的投票与它看到的证据。
3. CI 门禁
claude plugin eval . \
  --trust-plugin \
  --json results.json \
  --threshold 0.8 \
  --model claude-sonnet-5 \
  --judge-model claude-haiku-4-5 \
  --no-publish \
  --max-cost-usd 20
| 退出码 | 含义 |
|---|---|
| 0 | 所有 case ≥ 阈值,且所有 case 文件加载成功 |
| 1 | 有 case 低于阈值;case 文件加载失败;没找到 case;目录未受信且没传 --trust-plugin;参数非法 |
| 2 | 部分运行:触达成本上限,或凭证被拒绝(结果带 partial: true) |
| 130 / 143 | 被中断 / 被终止(如 CI 超时) |
关键:Δ 只被报告,永远不影响退出码。 CI 门禁卡的是 with 臂的绝对分数;想卡 Δ,需要自己解析 aggregate-result.json 里的 cases[].aggregates.delta。
CI 其它要点:runner 需安装 Claude Code 并在环境变量里提供凭证;把 evals/results/ 加入 .gitignore;趋势图里剔除 partial: true 和带 skippedPaidGraders 的结果;每次改动都跑的“快套件”只放免费 grader 并用 --ablation none。
4. 长期维护清单
- 为关键 skill 同时保留“应该触发”和“不应该触发”的 case。
- 固定
--model与--judge-model,让分数跨时间可比;换模型当作一次受控实验。 - 新模型发布、插件重大改动后重跑 suite。
evals/入库,evals/results/忽略;mocks/.replay/要入库,保证 CI 可重复。- 优先免费 grader,
llm/baseline只在必须时使用。
五、工作原理
- 写用例:在插件的
evals/下,每个场景一个目录,包含prompt.md(或case.yaml)和graders/,每个 grader 一个文件。可用claude plugin eval init让 Claude 帮你生成。 - 执行:运行
claude plugin eval .。每个 case 开全新的非交互会话,一组只加载你的插件,另一组什么都不加载,各跑 3 次(默认值),共 6 个会话。会话环境是干净的,没有 CLAUDE.md、用户设置和其他 skill。 - 打分:用 grader 做通过/失败判定,既有
tool_used、regex这类确定性检查,也有llm评判。单次 run 的分数是通过的 grader 占比,case 分数是各次 run 的平均值。 - 对照:输出 WITH(有插件)、W/OUT(无插件)和 Δ(二者之差),同时生成 JSON 和 HTML 报告。
- 接入 CI:用
--threshold设分数门槛。成本上限等其他参数以--help为准。
核心:用 Δ 衡量插件的边际贡献,而不是看绝对分数。Δ 接近 0 说明基础 Claude 本来就能做,或者 skill 没被触发。Δ 的可信度取决于 grader 设计,建议同时覆盖结果是否正确,以及是否真由插件产出(如 skill 是否被调用)。
陆、边界与陷阱
- Δ 才是插件贡献的度量,但它不是 CI 的退出条件。
- 先让触发稳定,再优化输出。 触发都不稳,后面的质量分没有意义。
- 双臂下部分 grader 自动不计分(
scored: false):所有tool_used: Skill、指向插件自带 MCP 的mock_calls检查,以及你标了arm: with-only的 grader,会在两臂都被排除,只在 with 臂显示 pass/fail 指示。若 case 的 grader 全被排除,则退回正常计分;arm: both可强制两臂都计分;--ablation none下什么都不排除,所以同一 suite 单臂与双臂的绝对分数可能不同。(因此对tool_used: Skill来说,arm: with-only其实是默认行为,显式写出只是增强可读性。) - 隔离会话不等于真实环境:你的用户设置、hooks、
CLAUDE.md、个人 MCP、其它已装插件、memory、其它 skill 全都不加载;Artifact 工具关闭;case 定义对被测 agent 不可见;受管策略仍会生效。 - run 出错不等于 0 分:超时等异常 run 仍按已产出内容评分,
error字段非空只是标记;但用量/限流错误会让后续 run 大量得 0 分,且 suite 不会被标为partial,看到整体暴跌先查 NOTES 和error。 - 安全边界:评估插件等同于
--plugin-dir的信任决策,会在你的机器上以你的身份运行其 skills/hooks/agents;scaffold_script需--scaffold,真实 MCP 需--allow-real-servers/--mocks off;hooks 与真实 server 在沙箱之外。suite 通过不代表插件安全。 - 基线臂里找不到你的 agent 是正常的:without 臂没有加载插件,dispatch 插件 agent 会报
Agent type ... not found,预期内。 - 其它易踩坑:
regex默认只看last_message;trace是逐行 JSON,引号要写成\";files目标只是路径列表;file_exists只认本次 run 新建的文件;默认阈值 1.0 会让任何不完美的 case 导致退出码 1;基线臂缺失时给 case 加plugins: ["../.."]。
七、15 个追问:检验你是否真正掌握
说明:其中涉及官方文档明确说明的,直接引用机制;文档未覆盖的(标注“工程建议”),是基于机制的推断。
一、关于“测量什么”
Q1. WITH 与 W/OUT 都是 1.0、Δ = 0:是插件没用,还是用户本来就能做好?
这两种说法往往是同一件事的两面,区分要看“过程”grader。
tool_used: Skill通过但 Δ=0:skill 被用了,却没改变结果。要么题目太简单(基础模型本来就会),要么你的结果 grader 太粗,看不出差别(比如只查了格式)。tool_used: Skill失败且 Δ=0:先是触发问题,Claude 靠自己做对了,所以没差异。
后续行动不同:题太简单 → 换成只有插件能做好的场景(团队私有规范、模型不知道的上下文、特定产出结构),收紧 grader;确认任务不简单仍无差异 → 老实问自己这个 skill 是否值得发布。注意 Δ 只衡量你写进 grader 的维度,速度、token 开销、一致性不在其中。
Q2. “没触发”与“触发了但结果差”,哪个对作者更致命?
没触发更常见,也更隐蔽:整个插件的价值为零,且后面的质量设计全未被检验。官方把触发列为第一发现,正是此意。触发了但结果差则更“显眼”,Δ 为负代表插件在拖后腿,属于主动伤害。建议的排障顺序:先修触发(description),再修结果(skill 正文)。
Q3. 去掉无插件基线会失去什么?何时单臂就够?
失去的是“这是不是插件的功劳”。WITH 高可能只是模型本来就强,也无法判断新模型是否让你的插件变得多余。单臂够用的场景:调试 grader 本身(--ablation none 可省一半成本);每次提交都跑的快速回归(已通过双臂确认过 Δ);接续历史对话的 case(目标为路径时默认单臂,因为假设录制的对话已包含插件作用)。
二、关于 Grader 设计
Q4. 为什么 tool_used: Skill 不能直接计分?
因为无插件臂里这个 skill 不存在,该 grader 必然失败。若计分,W/OUT 会被系统性拉向 0,Δ 被机械性抬高,哪怕插件毫无贡献。所以官方在双臂下自动将其排除,只在 with 臂显示指示。反过来,“不该触发”类用例要在两臂都计分,设 arm: both 并配 min: 0, max: 0。
Q5. 何时优先免费 grader?何时免费 grader 会假通过?
优先免费 grader:断言结构化事实(命令是否执行、文件是否存在、输出是否含/不含某模式)、长输出(对文件内容用 regex,每次判定一致)、CI 快套件。工程建议:免费 grader 的“假通过”常来自检查得太浅——regex 命中的是回复里无关的位置;tool_used 的 input_match 过宽;file_exists 只证明文件存在,不证明内容正确;tool_order 只比较“第一个匹配”调用;tool_used: Skill 通过只说明 skill 被调用,不说明答对。因此需要“结果”与“过程”两类 grader 配合。
Q6. grader 三次 run 里有时过有时不过,如何区分随机性与 description 不稳定?
先在 report.html 里看是哪个 grader 在翻转。
- 翻转的是
tool_used: Skill:说明 description 处于“边缘触发”,这是真问题,要改 description,而不是多跑几次。 - 翻转的是
llmgrader:看 judge 的三次投票和它看到的证据,通常是 rubric 模糊或 judge 太小,换--judge-model或把 rubric 改成具体条件,必要时改用regex。 - 想看清分布:把该 case 的
runs提高(上限 50)。工程建议:同一个 case 在不同表述(paraphrase)下也跑一遍,若只在个别表述翻转,说明是描述覆盖不足。
三、关于成本与迭代效率
Q7. 何时用 --runs 1 --ablation none?何时必须回到默认?
前者用于:调 grader、排查某个 case、对 description 改动做第一眼验证。后者用于:宣称“Δ 变好了”、合并前、对比模型、任何要写进结论或进入门禁的数字。官方明确提醒:单次 run 有噪声,要用默认 3 次确认。另外,单臂下不会排除 tool_used: Skill,所以绝对分数和双臂不可直接比。
Q8. --threshold 怎么定?太高/太低各有什么问题?
阈值只作用于 with 臂的绝对分数。太高(默认 1.0):任何一次随机失败都会让 CI 退出码为 1,团队很快学会忽略红灯。太低:真实回归被淹没。注意粒度:1 个 grader、3 次 run 时,case 分数只能是 0、0.33、0.67、1,此时 0.8 实际等同于 1.0;2 个 grader 时则允许某个 grader 失败一次。工程建议:在稳定版本上连跑几次,观察分数分布,把线设在分布下沿略下方;关键 case 用 tags 分层并单独收紧。
Q9. 预算超限,先砍什么?
工程建议的优先级,从“损失信号最少”到“最多”:①把能免费的 grader 换成免费的、日常迭代走 --ablation none;②用 --tag/--case 分层(smoke 常跑,全量低频跑);③改用更便宜的 judge(但小 judge 会误判,先验证稳定性);④最后才降低 runs 或删 case。关键 case 最后动,runs 降到 1 会让噪声吞掉信号。--max-cost-usd 只是保险丝,且是标价估算,不等于你的套餐用量。
四、关于与真实使用的关系
Q10. plugin-evals 不能告诉你什么?
它不能告诉你:真实对话里的触发率;多轮长期使用体验;与用户已装其它插件、CLAUDE.md、memory、个人 MCP、hooks 的相互干扰(这些在隔离会话里全都不存在);受管环境之外的行为;插件本身是否安全。它还要求你把测试题写得像真实用户的话,质量取决于你的 prompt 覆盖面。
Q11. evals 分数很高,真实用户却很少用,差了哪一层?
差“竞争”与“分布”两层(工程建议)。真实环境里你的 skill 要和用户已装的所有 skill/插件争夺选择,而 eval 是只有你自己的“净室”;你写的 prompt 也不等于用户的真实表述分布。补这一层用线上使用数据:官方的“Measure plugin cost and usage”文档讲插件给会话增加的上下文成本,以及人们是否仍在使用它。
Q12. 改完 description 后 Δ 上升,如何确认不是“适配了你的测试 prompt”?
这是过拟合问题(工程建议):①把 case 分成“调参集”和“留出集”,改动只依据前者,用后者验收;②为同一意图写多种说法(口语、简写、带噪声);③保留“不该触发”的 case,防止 description 越写越宽;④不要在 prompt 里提 skill 名字;⑤优先看触发率与负例误触,而不是只看总分。
五、关于系统边界与可靠性
Q13. 何时写 case.yaml?scaffold_script 和 mocks/ 各解决什么、引入什么风险?
只需 prompt 时不用写。需要 context.*(造文件/git、接续对话、只读夹具),或想把整个 case 写进单一文件时才用。
scaffold_script:解决“空目录起步”的问题。风险:它以你的身份在 agent 沙箱之外运行,需--scaffold,只有最小环境、120 秒超时,失败则该 run 记 0;且只能造文件和 git 状态,项目级配置不会被加载。mocks/:解决“不想依赖真实服务”的问题,并能用expect:断言插件发给服务的入参。风险:mock 与真实服务漂移(可用_tools.json保存真实工具 schema 缓解);type: agent的答案随 judge 变化,需把录制结果采纳到mocks/.replay/才可复现;mock 通过不代表真实服务可用;启用真实 server 则在沙箱外运行。
Q14. run 因超时/API 错误结束,但部分 grader 仍通过,怎么解读?
看 cases[].arms.with[].error。官方设计是:异常结束的 run 仍按已产出内容评分,所以非空 error 不等于 0 分。解读要分情况:基础设施问题(限流、用量耗尽、网络)是噪声,应剔除或重跑;与插件行为相关的超时(比如陷入循环、触顶 max_turns)是真信号。比较两臂:若只有 with 臂超时,更可能是插件引起。aborted(mock 的 expect 违规)记 0 分且 error 为 null;skippedPaidGraders 表示成本上限跳过了 judge,分数不可比。
Q15. 新模型发布后整体下降,是插件回归还是模型变化?
关键在于控制变量与利用双臂。官方建议在 CI 中固定 --model,避免把模型迭代误认为插件回归。做法:①同一版插件分别用旧、新模型各跑一遍;②看 W/OUT 是否同时变化——基线也变,说明是模型本身行为改变;基线不变而 with 变,才指向插件与新模型的兼容问题;③回到 tool_used: Skill:触发率下降说明新模型的选择行为变了,需要重写 description;④用 --judge-model 固定判官,避免“判官变了”被误读。设计上,你的 suite 有双臂、固定模型参数与结构化 JSON,已具备支持这种区分的条件,前提是你把 Δ 和触发指示都存下来。
八、总结:掌握的标志
当你能自然地回答下面这些问题,就基本掌握了 Plugin Evals:
- 这个 skill 在自然表述下会被触发吗?(
tool_used+ 负例) - 触发后是否明显优于无插件?(Δ 为正且稳定)
- 改动后是变好还是变差?(固定模型、同一 suite、3 次双臂)
- 失败的是插件、judge、grader 还是环境?(
report.html、error字段、scored: false指示) - 成本与信号怎么平衡?(免费 grader 优先、分层运行、合理阈值)
Plugin Evals 不是“再加一层测试”,而是让插件开发从“凭感觉”走向“有证据”。从今天开始,给你最重要的 skill 写第一个 case,跑一次,看一眼 Δ。